Title here
Summary here
Accéder aux notebooks et aux instructions
Des notebooks pédagogiques pour découvrir, étape par étape, comment appliquer des méthodes de ML aux données matériaux.
Ces notebooks constituent un support de formation (version 1.0). Ils illustrent un enchaînement pratique, de la compréhension des données expérimentales à la construction de modèles prédictifs, jusqu’à l’exploration d’approches plus avancées. Ils sont conçus comme un point de départ, à adapter à vos propres données matériaux. Les résultats dépendent de la qualité et de la taille du jeu de données, et les choix présentés sont des repères plutôt que des règles universelles.
La plupart des notebooks contiennent les explications et les consignes nécessaires pour comprendre et exécuter l’enchaînement proposé. Vous pouvez les suivre comme un parcours complet, ou ouvrir directement un notebook particulier si une étape ou une méthode vous intéresse.
L’enchaînement global est illustré ci-dessous. Les premières étapes portent sur la qualité et la compréhension des données ; les branches suivantes introduisent la prédiction, la réutilisation de modèles, la découverte causale et l’optimisation bayésienne. Les cases bleues sont les étapes de l’enchaînement et les cases jaunes les applications. Le schéma fait aussi apparaître une étape optionnelle d’augmentation de données, qui n’est pas traitée dans ce guide.
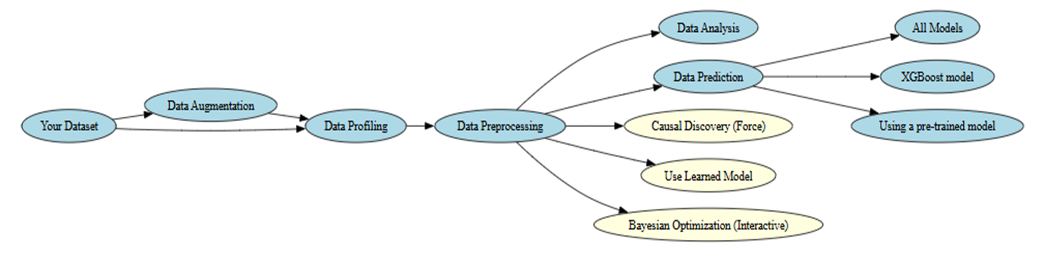
Les notebooks peuvent être suivis dans cet ordre, mais ils sont aussi conçus pour être utiles indépendamment. Vous pouvez aller directement au notebook qui correspond à la question que vous souhaitez explorer. Le notebook d’index (notebooks/index.ipynb) renvoie vers les principaux notebooks.
Il vous faut l’un des éléments suivants : Apptainer, Docker, ou Python 3.10+ avec uv et Graphviz. Les instructions détaillées sont disponibles dans le dépôt du tutoriel.
Première étape : vérifier la qualité du jeu de données de départ.
Notebook : preprocessing.ipynb
Ce notebook aide à repérer les problèmes de qualité des données avant toute analyse ou modélisation.
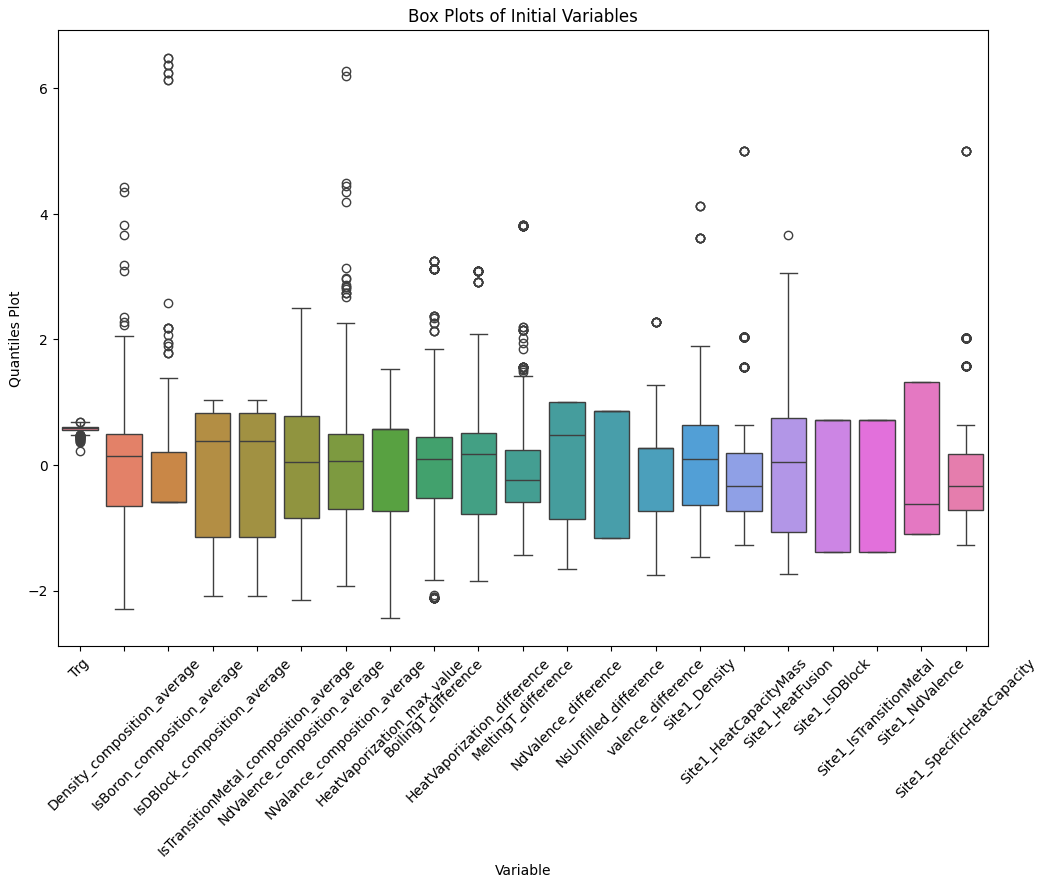
Étapes :
Une valeur aberrante n’est pas forcément une erreur
Une valeur aberrante n’est pas nécessairement une erreur : il peut s’agir d’une mesure réelle. Examinez les lignes signalées avant de décider de les retirer.
Se faire une première idée de la structure des données, sans chercher à prédire une cible.
Notebook : analysis.ipynb
Une introduction à quelques méthodes non supervisées : corrélations, réduction de dimension et clustering.
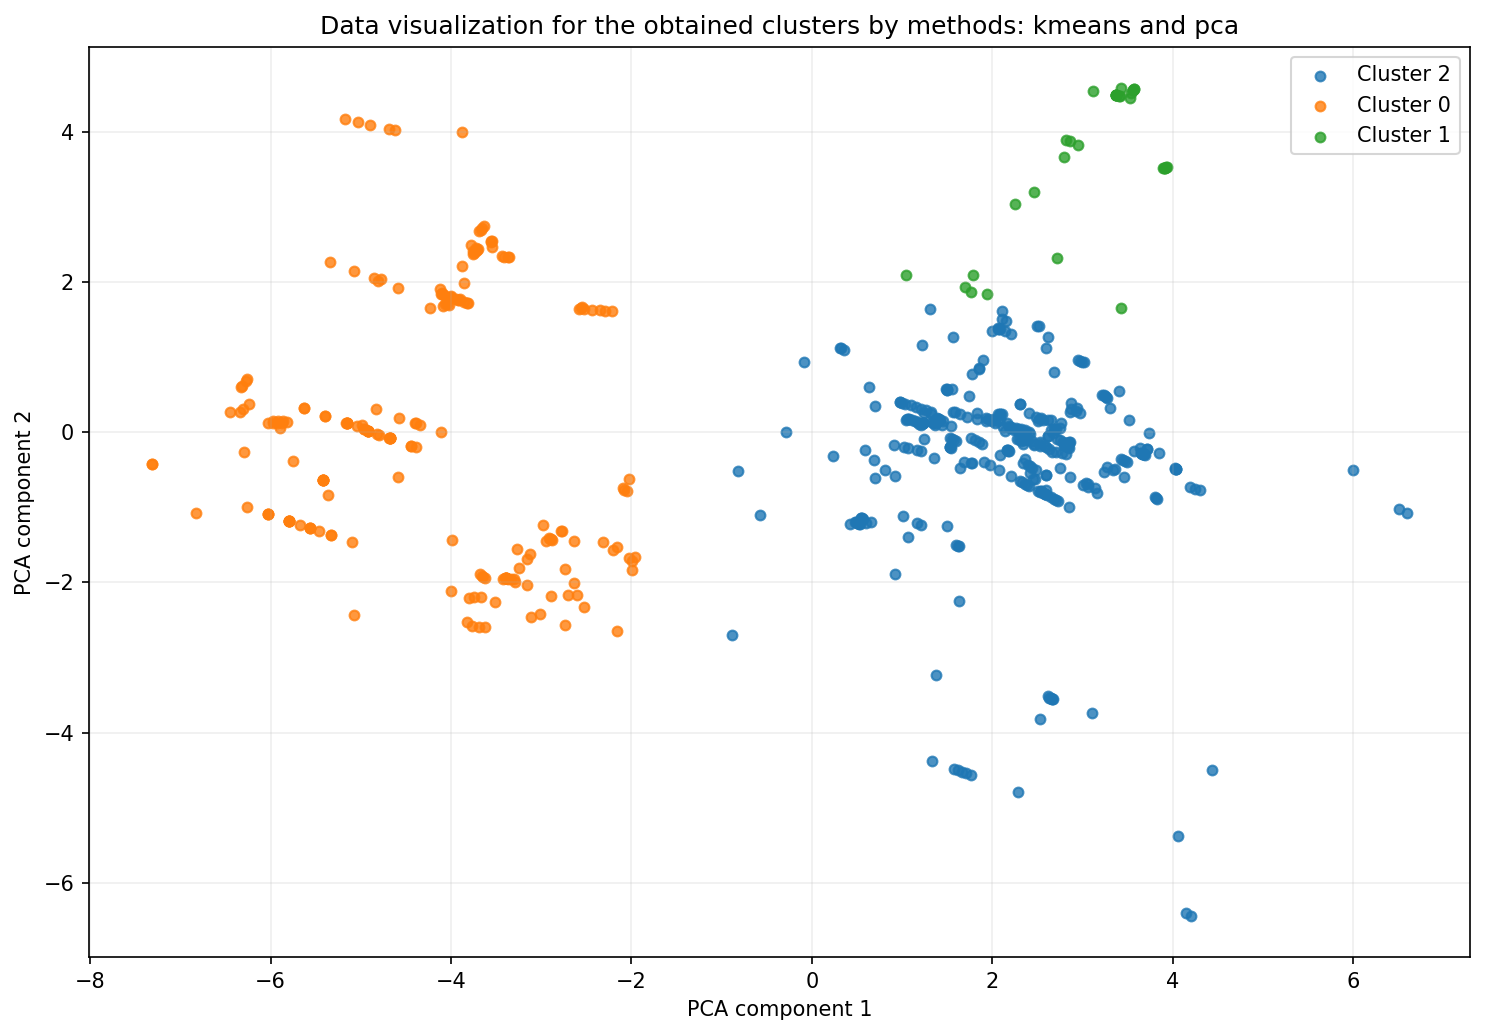
Étapes :
Profiler le jeu de données.
Calculer les corrélations et les lire sur la carte de chaleur.
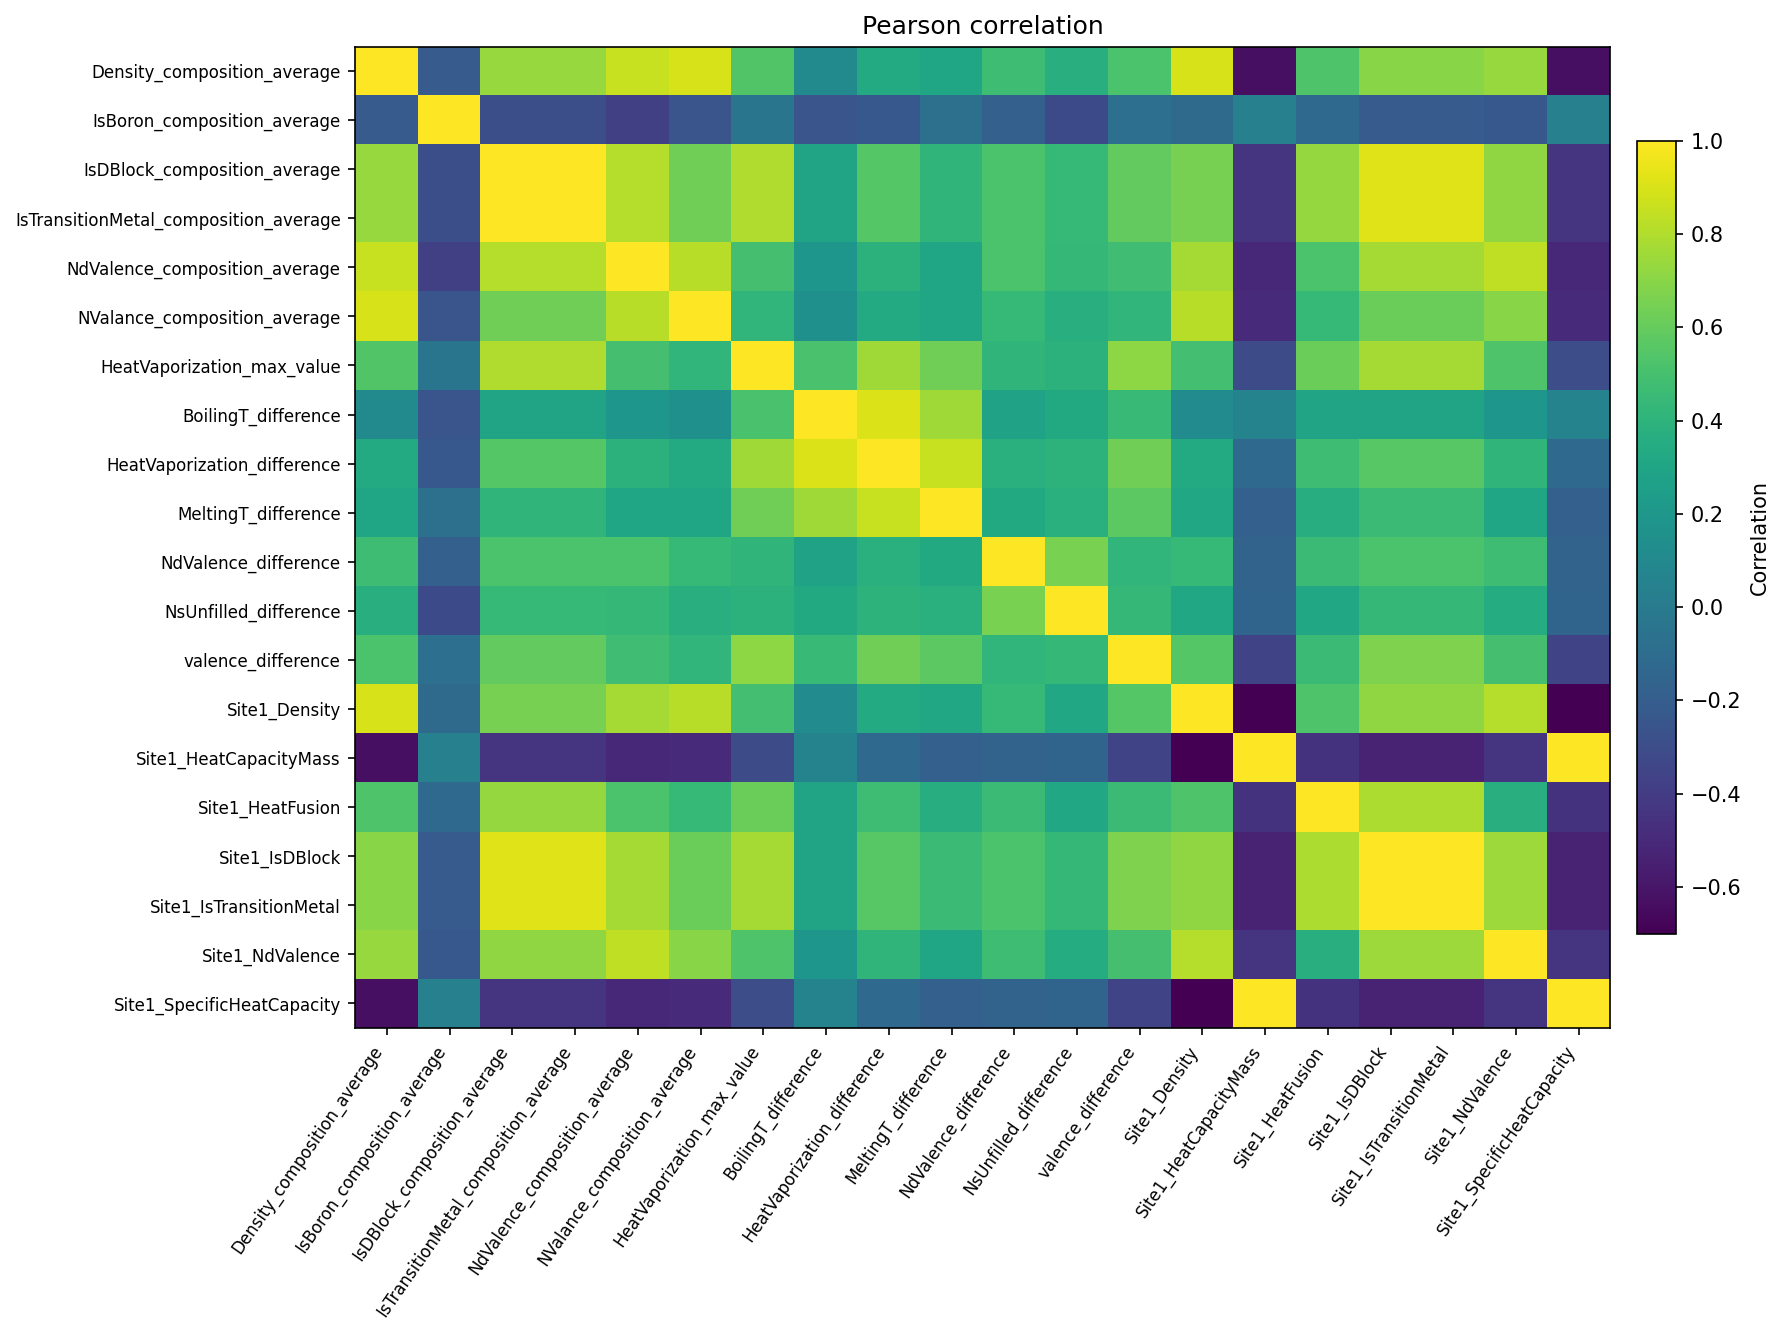
Réduire la dimension avec une analyse en composantes principales (ACP) : suivre la variance expliquée cumulée et choisir le nombre de composantes selon un seuil, par exemple 90 ou 95 %.
Essayer une méthode de clustering (K-Means, agglomératif ou DBSCAN) et ajuster ses hyperparamètres.
Projeter les groupes, comparer leurs centres, puis exporter les données avec une colonne d’identifiant de cluster.
Exemple. Remarquer que deux variables fortement corrélées portent presque la même information, puis vérifier avec l’ACP si quelques composantes suffisent à représenter le jeu de données.
Les clusters dépendent de la méthode
Les clusters dépendent de la méthode et de ses réglages : comparez plusieurs méthodes plutôt que de considérer un résultat comme définitif.
Relier une variable cible à des variables explicatives, ou réutiliser un modèle déjà sauvegardé.
Notebook : modeling_all.ipynb
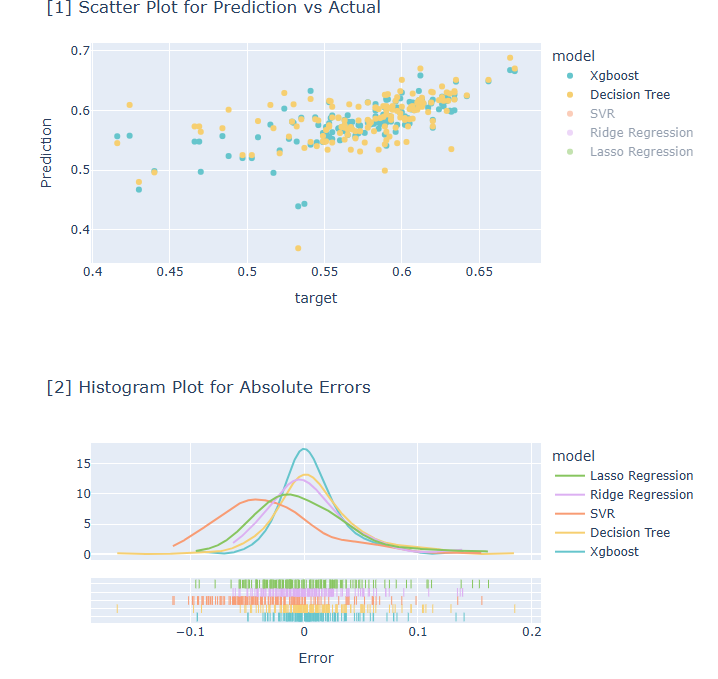
Un guide pour prédire une variable continue avec plusieurs algorithmes et comparer leurs résultats. Chaque algorithme est accompagné d’indications sur les cas où l’envisager.
Étapes :
Exemple. Sur un jeu de données où la relation semble linéaire et les variables corrélées, comparer Ridge ou Lasso avec XGBoost. L’export peut être nommé par version et par jeu de données, par exemple models_V01_metallic_glass.
Le choix du modèle reste empirique
Le choix d’un modèle reste une comparaison empirique : les indications données sont des repères.
Notebook : modeling_xgboost.ipynb
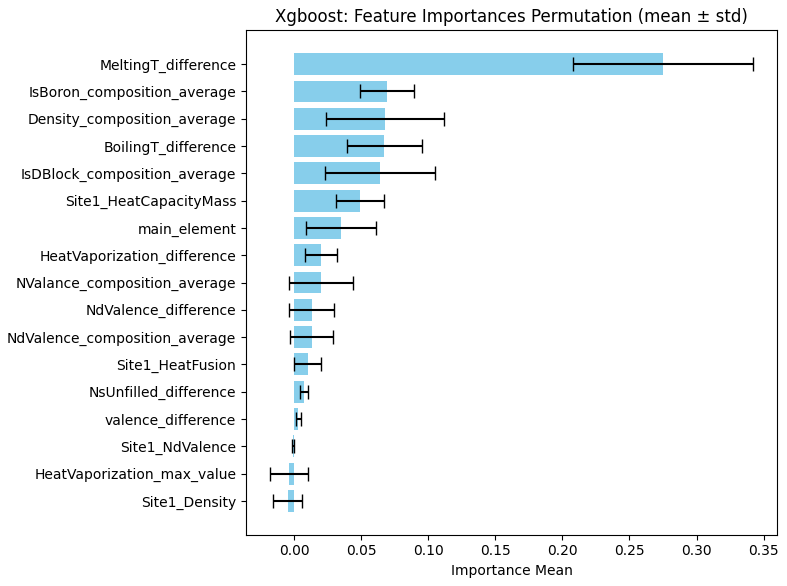
Un examen plus détaillé de XGBoost, qui construit des arbres en séquence, chacun corrigeant les erreurs des précédents, afin de comprendre l’effet de ses réglages.
Étapes :
Exemple. Comparer les métriques du modèle par défaut et du modèle optimisé pour juger si la recherche par grille apporte un gain notable sur votre jeu de données.
Limitation de plateforme
La recherche par grille de XGBoost n’est pas prise en charge sous Windows en mode local.
Notebook : modeling_prediction.ipynb
Montre comment réutiliser un modèle sauvegardé au format .pkl sur de nouvelles données, sans réentraînement.
Étapes :
.pkl).Exemple. Appliquer un modèle exporté depuis un notebook de modélisation à un nouveau lot d’échantillons, en vérifiant que ses variables d’entrée correspondent.
Des notebooks qui illustrent des approches plus avancées sur un cas concret. Ce sont des exemples de démarche, à transposer à vos propres systèmes. Le réentraînement des modèles est possible mais optionnel, et il est décrit à la fin de cette section.
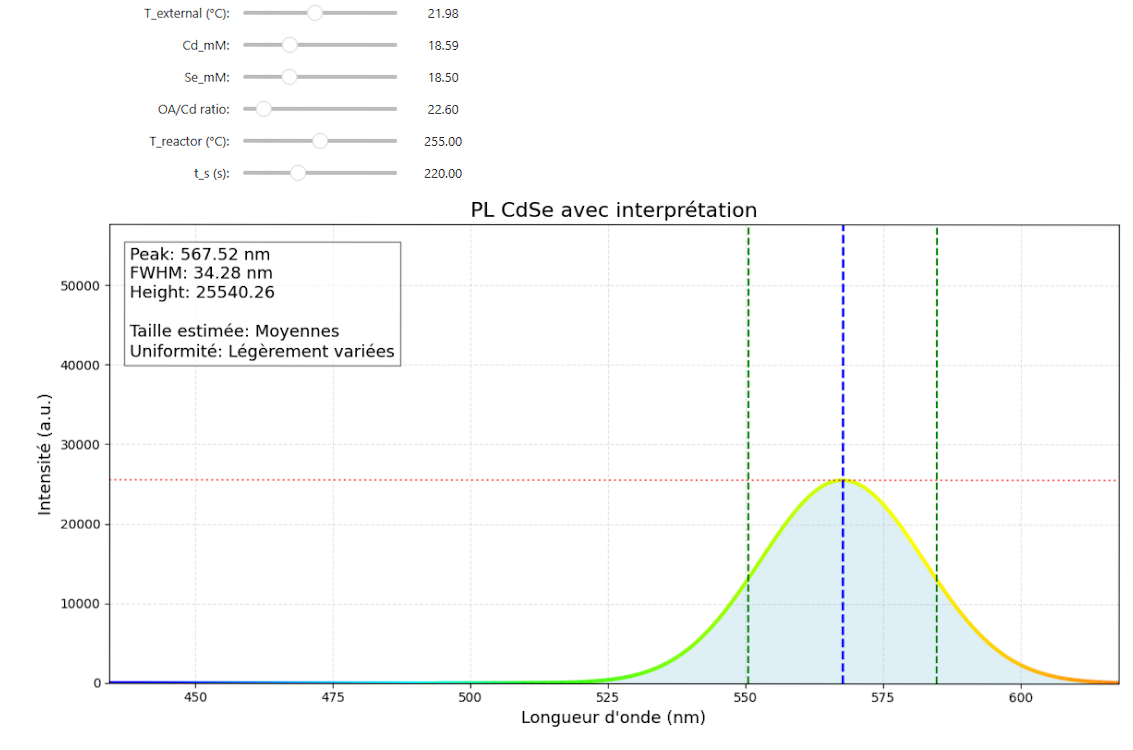
Les données. Chaque échantillon relie des paramètres de synthèse à une réponse optique.
T_external (température extérieure), Cd_mM et Se_mM (concentrations des précurseurs), OA_Cd_ratio (rapport ligand/métal), T_reactor (température de croissance), t_s (temps de réaction).Peak_nm (pic d’émission, lié à la taille moyenne), FWHM_nm (largeur spectrale, liée à l’uniformité) et height (intensité).Notebook : Use_Learned_Model.ipynb
Charge des modèles pré-entraînés et propose une interface pour explorer leurs prédictions.
Étapes :
Exemple. Fixer une combinaison de paramètres, prédire avec la forêt aléatoire puis avec le processus gaussien, et comparer les deux spectres.
Notebook : Causal_Discovery_Force.ipynb
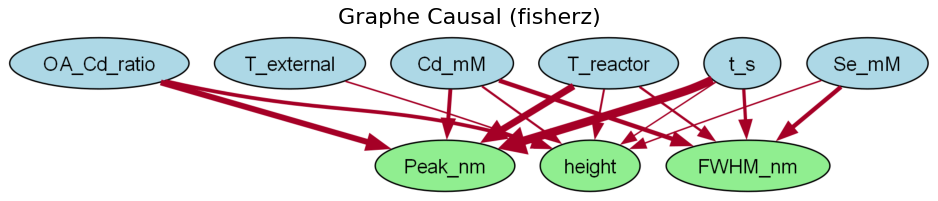
Une démonstration de découverte causale avec l’algorithme PC (Peter–Clark), à partir de données observationnelles.
Étapes :
CdSe_PL.csv par défaut).Exemple. Comparer les graphes obtenus avec Fisher Z et avec KCI pour voir quels liens dépendent de l’hypothèse de linéarité.
Un graphe est une hypothèse
Un graphe obtenu à partir de données observationnelles est une hypothèse à confronter aux connaissances du domaine, et non une preuve de causalité.
Notebook : Bayesian_Optimization_interactive_short.ipynb
Illustre le principe de l’optimisation bayésienne : un processus gaussien propose les prochaines conditions à tester et se met à jour avec les mesures. Il se prête aussi bien à l’enseignement qu’à l’expérimentation.
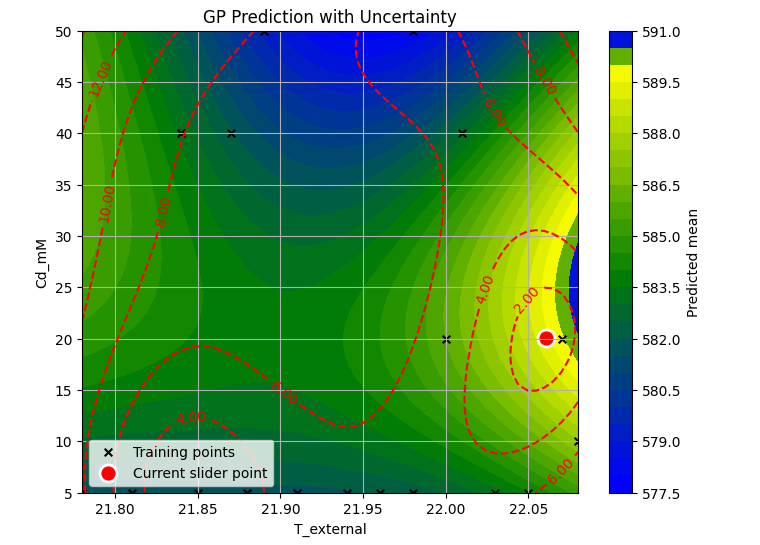
Étapes :
Notebook : Learn_Models_RF_GP.ipynb
Explorer le modèle appris utilise des modèles déjà entraînés. Si vous souhaitez comprendre comment ils sont construits, ou les reconstruire, ce notebook entraîne une forêt aléatoire multi-sorties et un processus gaussien à noyau de Matérn sur les données CdSe, puis sauvegarde les modèles avec leurs normalisations. Il n’est pas nécessaire pour suivre le reste.