Title here
Summary here
La recherche en science des matériaux produit des ensembles de données volumineux et variés : descriptions d’échantillons, de machines et de procédés, mesures, images, résultats de simulation… Pour être réutilisables, ces données doivent être stockées de manière organisée, reliées à leur contexte, et faciles à retrouver et à télécharger.
Le projet DIAMOND met à disposition une plateforme de données qui sert de socle à l’ingénierie des données pour la recherche : elle permet aux projets de déposer, structurer, retrouver et analyser des données hétérogènes (expériences et simulations, fichiers bruts et données saisies manuellement) sans nécessiter d’expertise en bases de données. Cette page explique comment utiliser cette plateforme pour déposer vos données et concevoir une base de données adaptée à votre projet DIADEM.
Pour répondre aux besoins du projet DIAMOND et du PEPR DIADEM, une architecture logicielle commune a été proposée à l’ensemble des partenaires. Cette architecture se divise en trois parties distinctes :
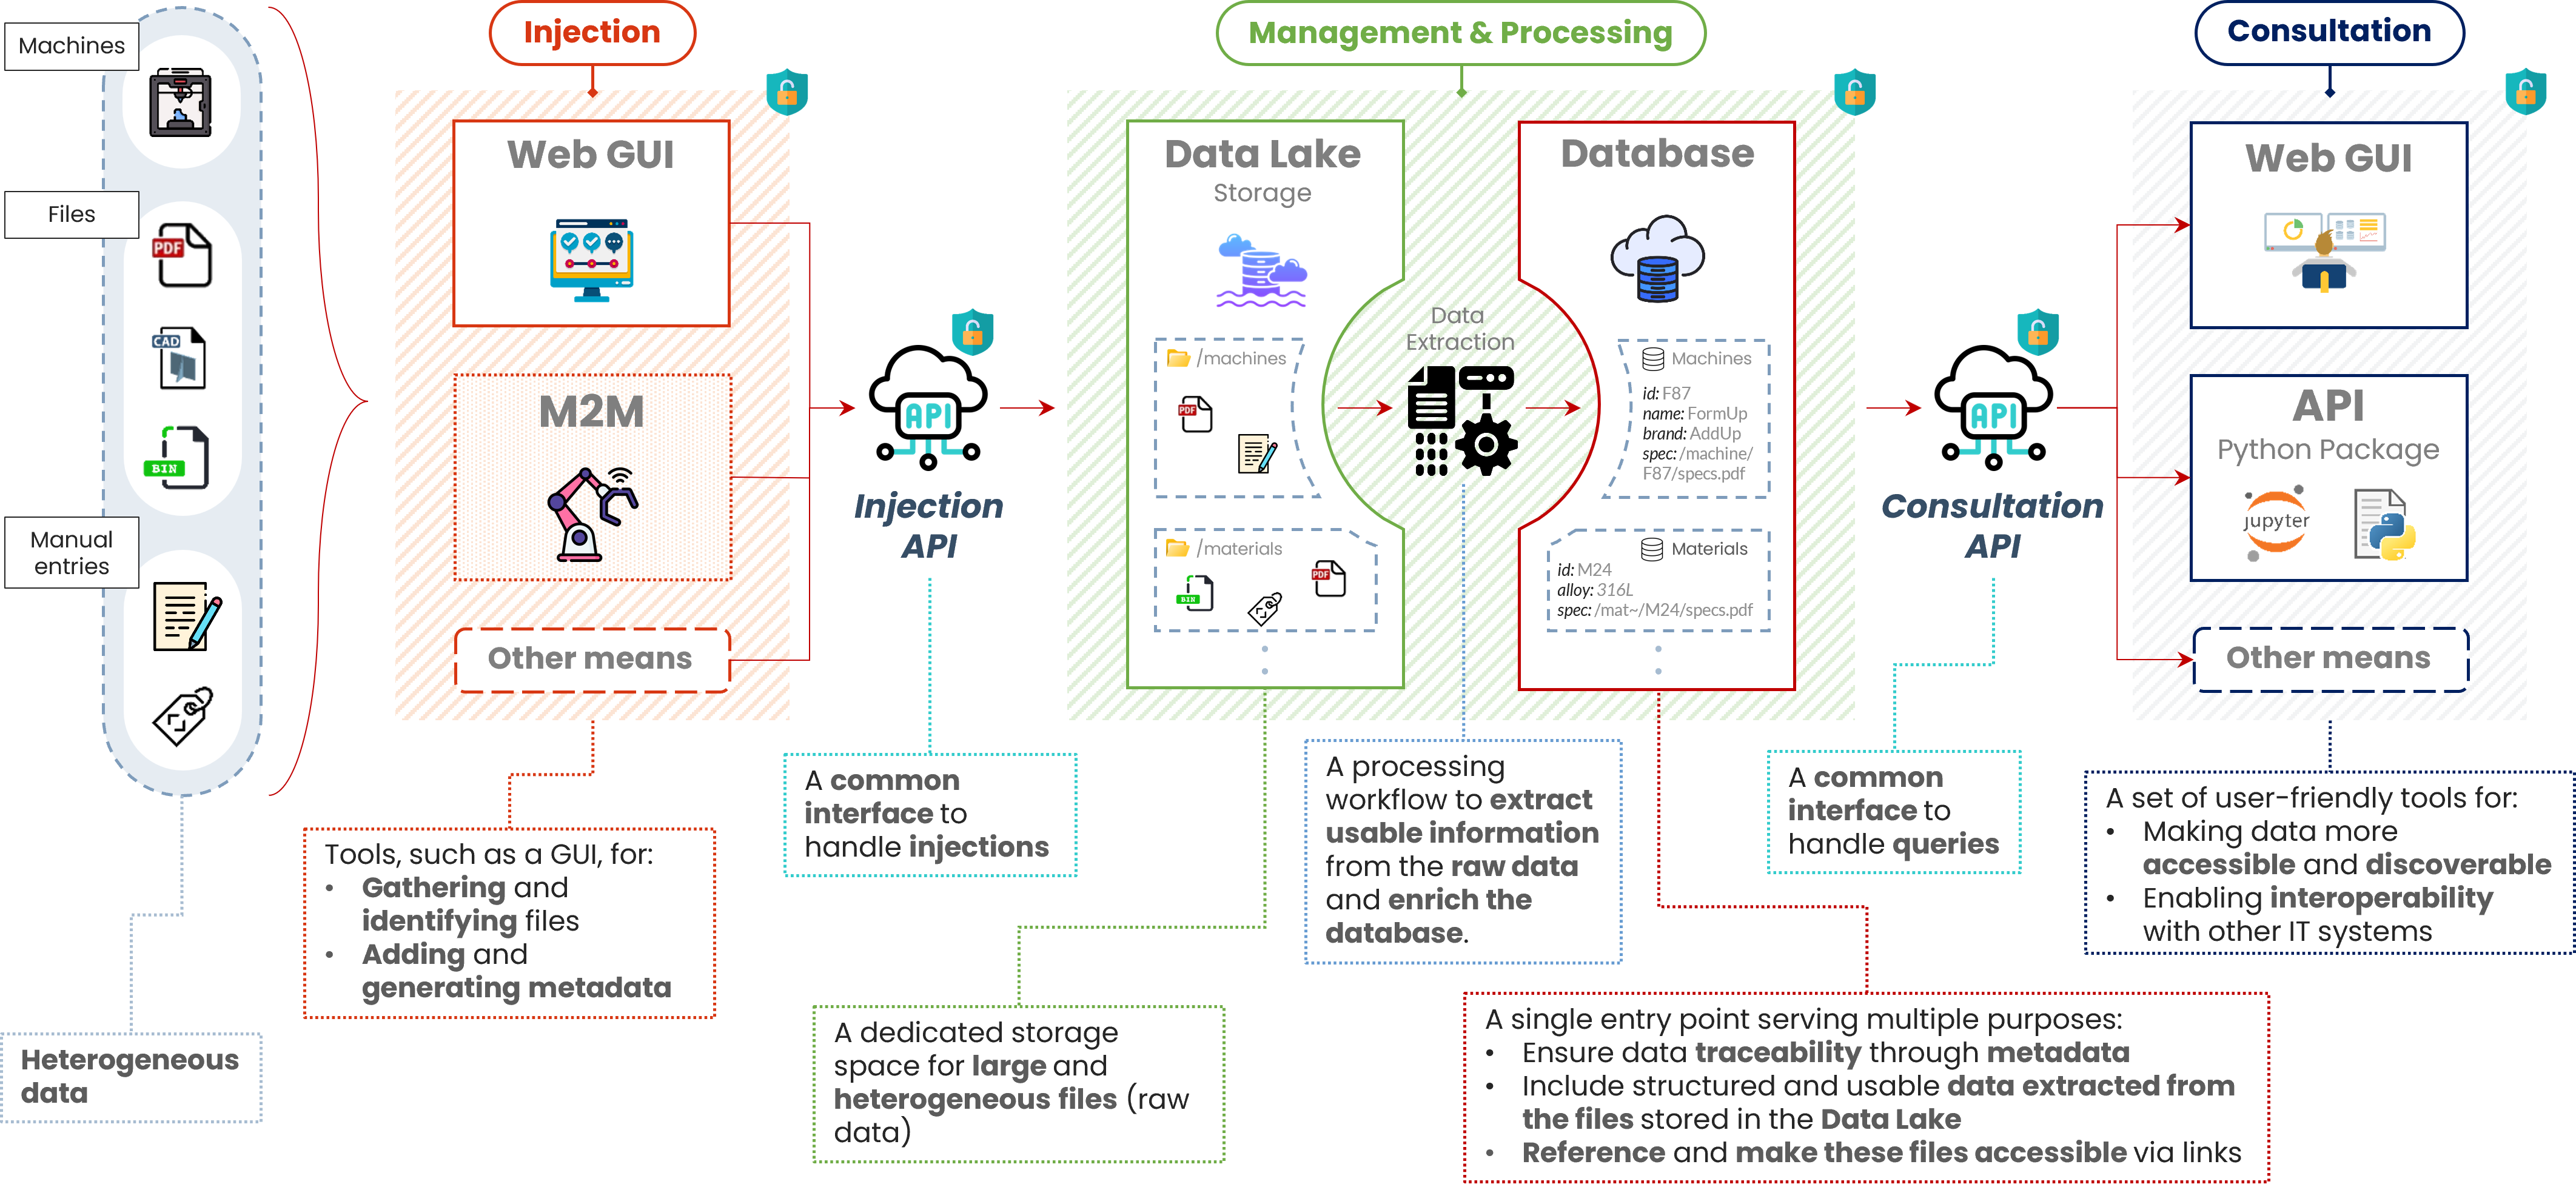
Architecture de la base de données
(En construction)
(En construction)
Cette section explique ce que vous devez préparer, et comment nous travaillons ensemble, pour obtenir votre propre base de données hébergée sur la plateforme DIAMOND-DM.
Nos données reposent sur une base de données NoSQL.
Concrètement, cela signifie que :
Cette flexibilité nous permet d’adapter la base de données à vos propres données (échantillons, machines, expériences, caractérisations, …). Deux notions clés sont utilisées tout au long du processus :
| Terme | Signification | En savoir plus |
|---|---|---|
| Collection | Un groupe de documents apparentés. À peu près équivalent à une « table » en SQL (p. ex. MACHINE, SPECIMEN). | Collections |
| Attribut | Une propriété d’un document (un champ), p.ex. Manufacturer ou Porosity Rate. | Documents and fields |
L’architecture générale est décrite dans la Section 1.
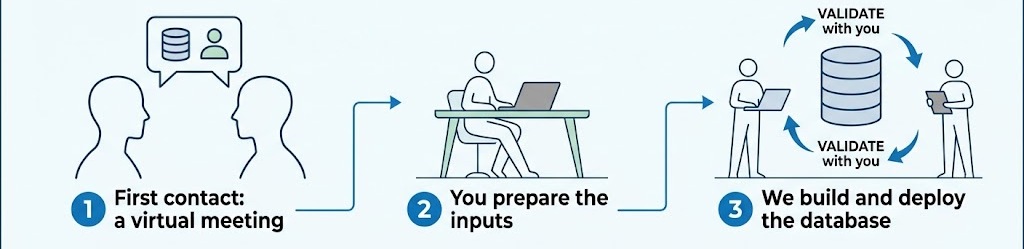
Itération avec l'utilisateur
| # | Élément | Obligatoire ? | Description |
|---|---|---|---|
| 1 | Modèle de données | Oui | Un fichier Excel suivant un modèle spécifique décrivant la « forme » de votre base de données. |
| 2 | Fichiers d’exemple | Oui | Un ensemble de fichiers typiques que les utilisateurs déposeront. |
| 3 | Algorithme d’extraction | Uniquement si certains attributs sont extraits de fichiers | Un script montrant comment lire les fichiers déposés et calculer/extraire les données pertinentes. |
Le modèle de données définit ce qui sera stocké dans la base de données et la façon dont les éléments sont reliés entre eux. Il doit être rédigé dans un fichier modèle Excel spécifique dans lequel vous définissez :
Vous pouvez télécharger ce modèle ici : Modèle de données (Excel).
Ce fichier inclut également l’exemple commenté décrit ci-dessous, afin que vous puissiez voir comment chaque colonne est utilisée.
Jetez-y un œil avant notre première réunion, et remplissez-le après notre discussion. Renvoyez-le-nous ensuite pour relecture.
Le modèle contient un exemple complet et commenté (ici pour une base de
données de fabrication additive). Ouvrez le fichier .xlsx et suivez les
explications qu’il contient : chaque ligne décrit un attribut d’une
collection, et l’exemple montre comment remplir chaque colonne.
Les collections de cet exemple (BUILD, MACHINE, MATERIAL BATCH,
SPECIFICATION, COMPUTER AIDED MANUFACTURING, COMPUTER AIDED DESIGN,
PLATE, SPECIMEN, CHARACTERIZATION) sont reliées entre elles comme suit :
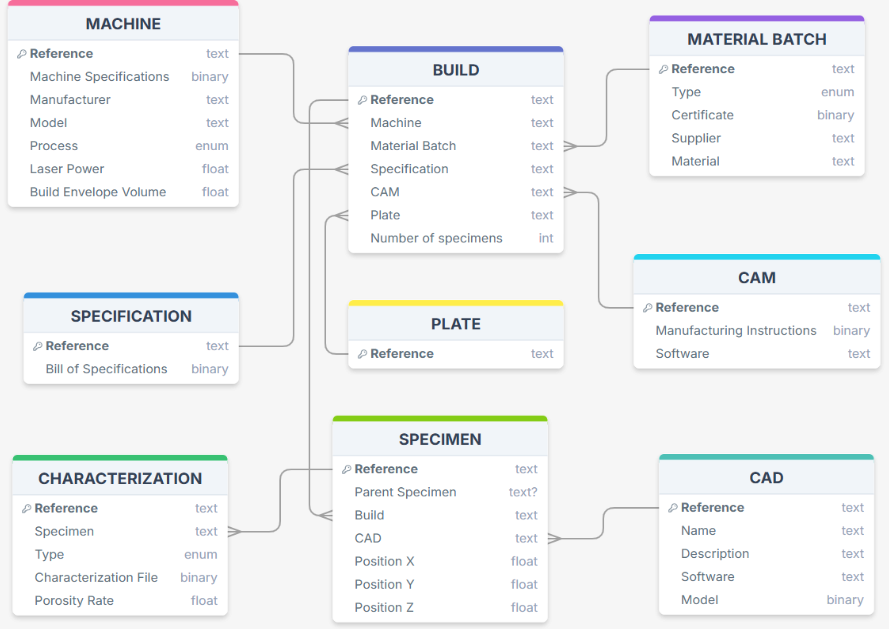
Relations entre les collections de l'exemple
| Colonne | Que renseigner |
|---|---|
| Collection | Nom de la collection à laquelle appartient l’attribut. |
| Attribute | Nom de l’attribut (propriété) au sein de la collection. À utiliser comme information sur laquelle les utilisateurs pourront ensuite filtrer lors de la recherche dans la base de données. |
| Capacity | Nombre maximal estimé d’éléments associés à l’attribut (1 pour une valeur unique, un nombre plus grand (ou n si ce nombre est inconnu) si l’attribut contient une liste). |
| Type | Type de données de l’attribut (voir types disponibles). |
| Required | true si l’attribut doit être renseigné lors du dépôt, false sinon. |
| Unit | Unité facultative de l’attribut (p. ex. mm, W, %). |
| Extension | Pour les attributs de type file : liste des extensions de fichier acceptées (p. ex. pdf; docx; txt). |
| Related to | Nom de la collection à laquelle l’attribut fait référence (voir Relations). |
| Extracted from | Nom de l’attribut file/image à partir duquel la valeur est extraite automatiquement (voir
Attributs extraits). |
| ConstraintType | Type de contrainte appliquée aux valeurs (voir contraintes). |
| ConstraintValues | Bornes ou ensemble de valeurs autorisées pour la contrainte. |
| Description | Description libre de l’attribut. |
| Types disponibles | Booléens | Types de contrainte | Cardinalité |
|---|---|---|---|
boolean | true | <= | one |
datetime | false | >= | list |
dict | < | ||
email | > | ||
enum | [ ] | ||
file | [ [ | ||
float | ] ] | ||
image | ] [ | ||
int | in | ||
long | |||
reference | |||
str | |||
url |
La colonne Related to définit les liens entre collections (similaires à des clés étrangères / pointeurs).
reference, Related to doit être renseigné et
doit contenir le nom de la collection cible.str servant d’identifiant d’un document d’une autre
collection (ou de la même collection, p. ex. un lien hiérarchique comme
Parent Specimen dans SPECIMEN), renseignez également la collection visée.Exemple : l’attribut Machine de BUILD est de type reference et est
relié à MACHINE.
Certaines valeurs ne doivent pas être saisies par les utilisateurs, car elles peuvent être lues ou calculées à partir d’un fichier déposé. Elles sont décrites par la colonne Extracted from.
file ou image
(p. ex. un fichier .csv, .xy, .jpg, .raw).Exemple : Porosity Rate dans CHARACTERIZATION est extrait de
CHARACTERIZATION/X-ray CT-scan ; Laser Power dans MACHINE est extrait
de MACHINE/Machine Specifications.
Les contraintes (ConstraintType + ConstraintValues) restreignent les valeurs acceptées pour un attribut.
int, float, …) ou aux énumérations (enum).file ou reference.(0; 100), et non
("0"; "100")).[ ] intervalle fermé, ] [ intervalle ouvert,
[ [ et ] ] intervalles semi-ouverts.in sert à indiquer une liste de valeurs autorisées (p. ex.
("Wire"; "Powder")).| Exemple | Type de contrainte | Valeurs | Signification |
|---|---|---|---|
MACHINE / Process | in | ("WAAM"; "LPBF") | Seules ces deux valeurs sont acceptées. |
MACHINE / Laser Power | [ ] | (100; 10000) | Valeur comprise entre 100 et 10000 (incluses). |
BUILD / Number of specimens | > | 0 | Nombre strictement positif. |
CHARACTERIZATION / Porosity Rate | [ ] | (0; 100) | Pourcentage compris entre 0 et 100. |
Astuce : pour une propriété vrai/faux, utilisez le type
booleansans contrainte. N’utilisez pas les valeurs0/1avec un booléen.
Les utilisateurs qui injectent des données dans la base de données déposeront
des fichiers (cahiers des charges, données machine, modèles 3D, images de
tomographie, …). Ces fichiers sont stockés dans le data lake et peuvent
être téléchargés par les utilisateurs qui consultent la base de données.
Les attributs de type file ou image de votre modèle de données sont ceux
qui reçoivent ces dépôts.
Vous pouvez nous envoyer autant de fichiers que vous le souhaitez pour alimenter la base de données lors de sa création, mais nous avons besoin d’au moins quelques fichiers d’exemple typiques pour chaque type de fichier qui sera déposé. Ils nous permettent de tester et de valider la base de données et l’algorithme d’extraction.
Exemples typiques (issus de l’exemple de fabrication additive) :
| Attribut associé | Nom de fichier d’exemple |
|---|---|
| Machine Specifications | wlam_machine.pdf |
| Certificate | certificat_316L.pdf |
| Bill of specifications | cahier_des_charges.pdf |
| Manufacturing Instructions | plateau.gcode |
| Model | cube.stp |
| X-ray CT-scan | tomography.raw |
Si certains attributs sont extraits de fichiers déposés (colonne Extracted from), nous avons besoin d’un algorithme montrant comment :
Il s’agit généralement d’un court script (p. ex. en Python) qui prend un fichier en entrée et renvoie les valeurs des attributs. Les fichiers bruts restent disponibles au téléchargement, tandis que les valeurs extraites sont stockées dans la base de données et peuvent servir à rechercher et filtrer les données.
Exemple : un script qui ouvre le fichier déposé dans Machine Specifications
(p. ex. wlam_machine.pdf), trouve le fabricant, le modèle et la puissance
laser maximale, et les renvoie comme valeurs des attributs Manufacturer,
Model et Laser Power de la collection MACHINE. L’utilisateur dépose
uniquement le fichier ; les trois valeurs sont renseignées automatiquement.
La même logique s’applique aux valeurs stockées dans les métadonnées des fichiers (p. ex. dates, réglages d’instruments, dimensions d’images) ou calculées à partir du contenu du fichier.
Si votre modèle de données ne comporte aucun attribut Extracted from, vous
n’avez pas besoin de cette étape.
Avant notre première réunion, il est utile d’avoir réfléchi à :
Vous pouvez nous contacter via le formulaire général : Formulaire de contact.
Vous pouvez également joindre directement les personnes en charge de la gestion des données, de l’accès à la base de données, du modèle de données et des ontologies :
| Sujet | Contact |
|---|---|
| Coordination | thierry.deutsch@cea.fr |
| Développement de la plateforme de base de données | imanol.setoain@cea.fr |
| Ontologies | cinthya.herreracontreras@cea.fr |